概率论笔记:Chebyshev 不等式与大数定理
这篇抄书笔记继续源于最近读完的 A Mathematical Bridge。在概率论的版块中,作者 Stephen Hewson 介绍了所有概率论教材必然都会讲述的极限定理(limit theorems)。我计划分成两篇笔记来写,这篇水完之后,打算再来糊一篇更带劲的关于中心极限定理(central limit theorem)的抄书笔记,争取不烂尾。
重温这些定理,我依然会感到数学世界的魔力:仅靠很少量的信息,就可以得到关于随机事件发生概率的一些量化的估计,而且定理的证明和结果都非常漂亮。
Markov 不等式
Markov 不等式(Markov’s Inequality)可以给出一个非负随机变量超过某个特定值的概率上界。设 \(X\) 为任意非负随机变量,对于任意 \(a>0\) 有:
\[P(X \geq a) \leq \frac{\mathbb{E}[X]}{a}\]证明
将 \(X\) 是离散变量或是连续变量的情况分开讨论。
若 \(X\) 是非负的离散变量(discrete random variable):
\[\begin{align*} P(X \geq a) & = \sum_{k\geq a} P(X=k) \\ & = \frac{1}{a} \sum_{k\geq a} aP(X=k) \\ & \leq \frac{1}{a} \sum_{k\geq a} kP(X=k) \\ & \leq \frac{1}{a} \sum_{k\geq 0} kP(X=k) \\ & = \frac{1}{a} \mathbb{E}[X] \end{align*}\]对 \(X\) 是连续变量(continuous random variable)的情形,证明思路非常类似:
\[\begin{align*} P(X \geq a) & = \int_a^\infty \rho(x) \,\mathrm{d}x \\ & = \frac{1}{a} \int_a^\infty a \rho(x) \,\mathrm{d}x \\ & \leq \frac{1}{a} \int_a^\infty x \rho(x) \,\mathrm{d}x \\ & \leq \frac{1}{a} \int_0^\infty x \rho(x) \,\mathrm{d}x \\ & = \frac{1}{a} \mathbb{E}[X] \qquad \square \end{align*}\]举例和讨论
Markov 不等式在直觉上很 make sense:如果随机变量 \(X\) 的期望值 \(\mathbb{E}[X]\) 不大,那么它超过某个比较大的 \(a\) 值的概率肯定也不会很高。
举两个量化一丢丢的例子。比如我们备战由一大堆选择题构成的一门考试(假定类似限时挑战的规则,题目数量不限,能赶着做对几个算几分),平时模拟练习你平均能做对30个,根据 Markov 不等式,你在正式考试能超水平发挥做对40个以上的概率不会超过:\(P(X\geq40) \leq \frac{30}{40} = 75\%\).
更经典的例子比如某地人群的平均月收入在 8000 水平,根据 Markov 不等式,月收入超过 40000 的超高收入人群占比不会高于:\(P(X\geq40000) \leq \frac{8000}{40000} = 20\%\)。
常识和经验可以告诉我们,上面两个例子给出的概率上界明显是过高的,否则我们大可以成天去做考场中运气爆表或者一夜实现阶层跨越的黄粱美梦。Markov 不等式在很多时候给出的概率上界的确是过于宽松,但在除了期望值之外对概率分布的其他信息一无所知的前提下,也不失为一种简单粗暴的估计方法。
Chebyshev 不等式
Chebyshev 不等式(Chebyshev’s Inequality)进一步给出了随机变量偏离期望值超过一定程度的概率上界。设 \(X\) 为任意随机变量,如果其均值 \(\mu\) 和标准差 \(\sigma\) 都是有限值,对于任意 \(a>0\) 有:
\[P\left( \big\vert X - \mu \big\vert \geq a\right) \leq \frac{\sigma^2}{a^2}\]证明
\[\begin{align*} P\left( \big\vert X - \mu \big\vert \geq a\right) & = P \left( \left(X - \mu\right)^2 \geq a^2 \right) \\ & \leq \frac{1}{a^2} \mathbb{E}\left[\left(X - \mu\right)^2 \right] \qquad \text{by Markov's inequality} \\ & = \frac{1}{a^2}\text{Var}[X] \\ & = \frac{\sigma^2}{a^2}\qquad \square \end{align*}\]举例和讨论
继续以先前设定的考试举例,假定平时模拟练习时的平均水平还是能做对30个,但练习时的正确率波动范围在 \(\pm 5\) 个题目,根据 Chebyshev 不等式,你在正式考试超神发挥做对40个以上或者超鬼发挥做对不到20个的概率上界:
\[P\left( \big\vert X - 30 \big\vert \geq 10 \right) \leq \frac{5^2}{10^2} = 25\%\]这个轻松估计出来的结果看起来比 Markov 不等式给出的上界更紧了点(毕竟多了点标准差的信息),但是还是有不少水分。
Chebyshev 不等式在直觉上说的其实也就是随机变量的取值大概率是落在期望值附近的,不太会距离期望值太远。我们可以对 Chebyshev 不等式稍作改写,然后再给一个有具体数值的估计,来点更直观地感受。若记 \(a = k\sigma\),考虑 \(X\) 的取值落在 \(k\) 倍标准差之外,即落在 \((\mu - k\sigma, \mu+k\sigma)\) 范围之外的概率上界为:
\[P\left( \big\vert X - \mu \big\vert \geq k\sigma \right) \leq \frac{1}{k^2}\]代入特定的 \(k\) 值,把 Chebyshev 不等式给出的结果和正态分布的相应结果放在一起比较
| Chebyshev 不等式 | 正态分布 | |
|---|---|---|
| \(P\left( \big\vert X - \mu \big\vert \geq \sigma \right)\) | \(\leq 100\%\) | \(31.7\%\) |
| \(P\left( \big\vert X - \mu \big\vert \geq 2\sigma \right)\) | \(\leq 25\%\) | \(4.5\%\) |
| \(P\left( \big\vert X - \mu \big\vert \geq 3\sigma \right)\) | \(\leq 11.1\%\) | \(0.27\%\) |
| \(P\left( \big\vert X - \mu \big\vert \geq 5\sigma \right)\) | \(\leq 4\%\) | \(0.000057\%\) |
可以看到,Chebyshev 不等式的精度似乎也不是特别给力。然而,Chebyshev 不等式在实际应用中其实非常管用,因为很多时候我们可能也就只能知道关于期望值和标准差的信息了,在对概率分布的其他特点知之甚少的前提下,Chebyshev 不等式给出的上界已经是可以做到的最好了。事实上,我们可以构造出特别的概率分布,使得对于特别的 \(a\) 值,Chebyshev 不等式是可以取到等号的。
大数定理
在做实验、记录测量数据时,为了控制随机误差,我们通常会对某个数据进行多次重复测量再取其平均作为更可信的结果,这似乎是用屁股想都显而易见的操作。随着测量次数的累计,多次测量结果的平均值,理应趋于某个特定的极限值,而这个极限值也理应是那个待测量的真实期望值。
直觉上应该如此,数学上是否的确也是如此?这个问题其实往下想想还有一些值得挖掘的内容。好消息是,有了 Chebyshev 不等式,可以很快得到被称为大数定理(the law of large numbers)的结论。
若 \(X_1, X_2, \cdots, X_n\) 是一系列独立的随机变量,且它们均服从同一个期望值为 \(\mu\)、标准差 \(\sigma\) 有限的概率分布,那么这些随机变量的平均值在 \(n\to\infty\) 的极限下趋于概率分布期望值 \(\mu\),即:
\[\lim_{n\to\infty} \left( \frac{X_1 + X_2 + \cdots + X_n}{n}\right) = \mu\]证明
记 \(S_n = X_1 + X_2 + \cdots + X_n\),对于任意小的 \(\epsilon >0\),由 Chebyshev 不等式有:
\[P \left( \left\vert \frac{S_n}{n} - \mu \right\vert \geq \epsilon\right) \leq \frac{\sigma^2[S_n/n]}{\epsilon^2} = \frac{1}{\epsilon^2} \text{Var}\left[\frac{S_n}{n} \right]\]注意到 \(\frac{S_n}{n}\) 写开后是一堆独立随机变量 \(X_i\) 的总和,它们的和的方差可以拆分成它们各自方差的和,于是:
\[\begin{align*} \text{Var}\left[\frac{S_n}{n} \right] & = \text{Var}\left[\frac{X_1}{n} \right] + \text{Var}\left[\frac{X_2}{n} \right] + \cdots + \text{Var}\left[\frac{X_n}{n} \right] \\ & = n \text{Var}\left[\frac{X}{n} \right] \\ & = n \times \frac{1}{n^2} \text{Var}\left[X \right] \\ & = \frac{1}{n} \text{Var}\left[X \right] \end{align*}\]因此
\[P \left( \left\vert \frac{S_n}{n} - \mu \right\vert \geq \epsilon\right) \leq \frac{\text{Var}[X]}{n\epsilon^2}\]不论选取怎样的 \(\epsilon > 0\),总能找到充分大的 \(n\) 使得上式右边小到任意地趋近于零。如此我们就论证了大数定理的结论。 \(\qquad \square\)
举例和讨论
如果我们足够有耐心,可以整一枚骰子,不停地丢、同时记录每次丢出来的点数。显然,单次投掷得到的点数期望值是 \(\mu = \frac{1+2+3+4+5+6}{6} = 3.5\),我们可以试着统计实际丢出来前10次、前50次、前100次、前200次、前500次……的平均点数,大概率就会发现,投掷次数在几十次的时候,平均点数还会在 3.5 的上下有一定波动,但随着丢的次数越来越多,平均点数会越来越趋于稳定。当然有点编程基础的同学大可以让计算机去模拟这个投骰子的实验,这里我也直接盗用 Wikipedia 上现成的图给大家展示下一口气模拟 1000 次投掷跑出来的结果。
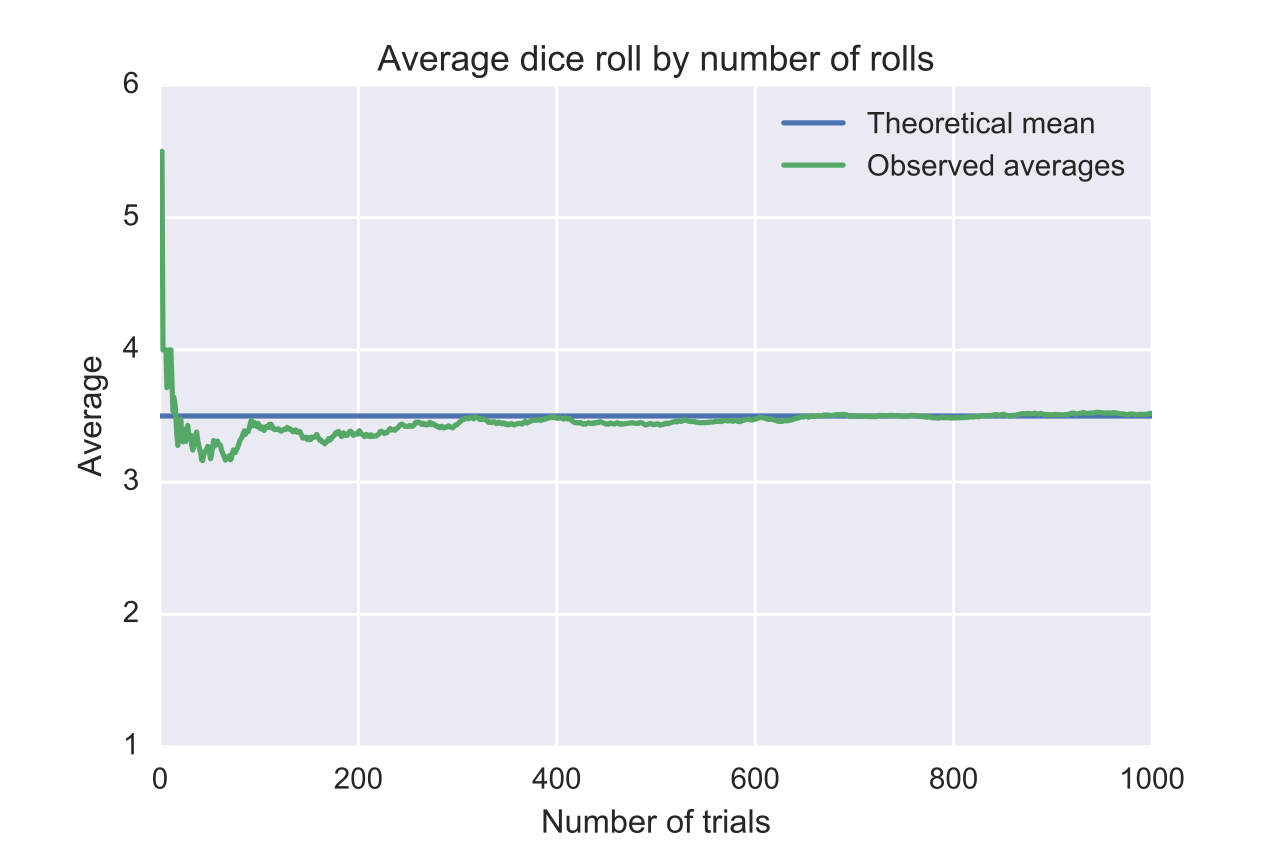
计算机算法中有一个被称作 Monte Carlo 的算法。它是一个简单粗暴、但是有时很管用的解决方案,而大数定理正是其背后的理论基石。Monte Carlo 算法通过模拟大量的随机试验,然后作统计平均获得近似的数值结果。著名的布丰投针(Buffon’s Needle Problem)估计圆周率,还有一些数值积分的算法,甚至是博弈决策(例如棋类游戏)的问题,都可以通过 Monte Carlo 算法来解决。对计算机算法感兴趣的同学,这里也就抛砖引玉啦。